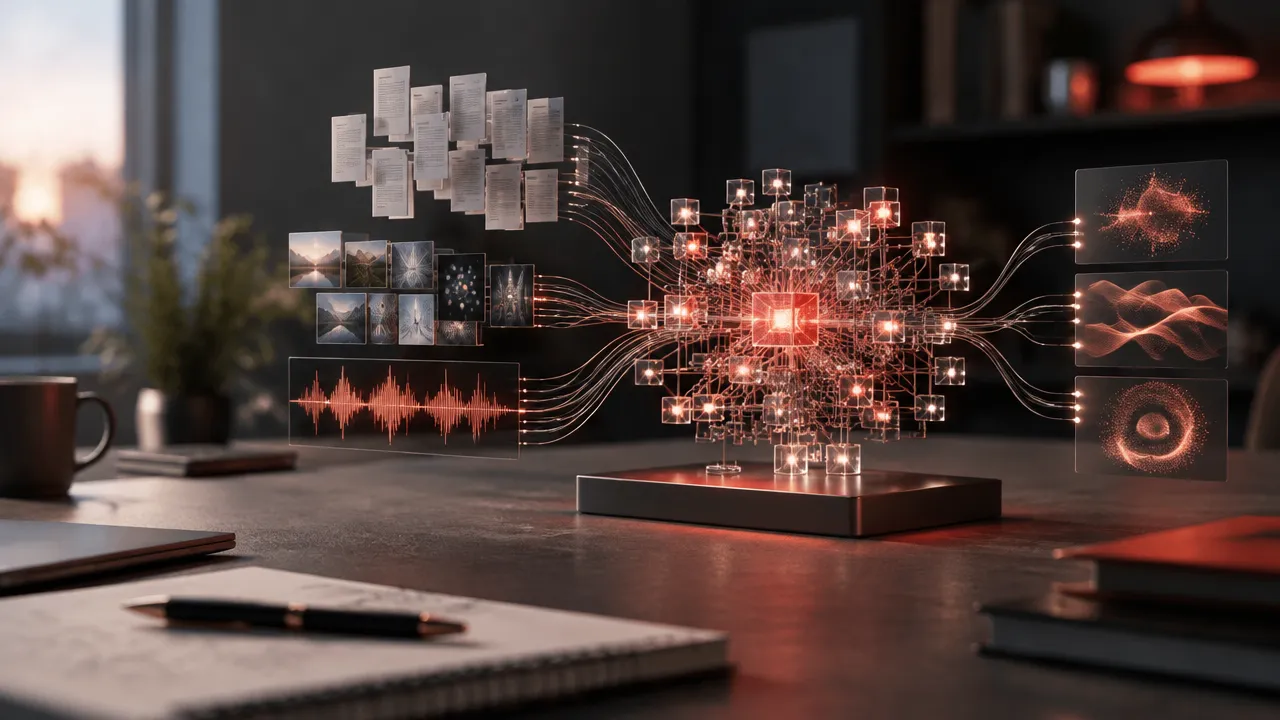
Modelos de IA generativa aprendem padrões em dados e usam uma arquitetura para produzir conteúdo novo, como texto, imagens, áudio ou código. Para startups e empresas, entender essas duas peças ajuda a escolher uma solução adequada ao trabalho, em vez de selecionar uma ferramenta apenas pela popularidade. A decisão também depende de como o modelo será integrado, verificado e atualizado.
O essencial sobre modelos generativos
- Os dados influenciam o que o modelo consegue reconhecer e produzir, mas não funcionam como uma garantia de que cada resposta esteja correta.
- A arquitetura define como o sistema processa informações e gera resultados. Modelos de linguagem e modelos de difusão, por exemplo, operam de formas diferentes.
- Instruções, busca em documentos e ajuste fino são maneiras distintas de adaptar um modelo a uma tarefa.
- Em uma aplicação empresarial, integração, segurança, custo e avaliação importam tanto quanto a qualidade da geração.
Um modelo generativo aprende padrões, não consulta uma enciclopédia
Um modelo generativo é um sistema treinado para identificar regularidades nos dados e produzir uma saída provável a partir de uma entrada. Em um assistente de texto, essa entrada pode ser uma pergunta; em um gerador visual, pode ser uma descrição da imagem desejada.
Isso não significa que o modelo guarde uma cópia consultável de cada texto de treinamento. Ele calcula a saída com base nos padrões aprendidos. Por isso, pode formular uma resposta convincente e ainda assim errar, especialmente quando faltam contexto, dados atualizados ou critérios claros.
Também é útil separar modelo e produto. ChatGPT, por exemplo, é uma experiência conversacional, não o nome de uma arquitetura. Entender essa diferença ajuda a comparar soluções e a pensar em como integrar capacidades de IA generativa a um aplicativo ou processo próprio.
Os dados moldam o que o sistema consegue fazer
A qualidade e a composição dos dados de treinamento influenciam os padrões que o modelo aprende. Em termos simples, um modelo de linguagem pode ser treinado com grandes coleções de textos; um modelo visual aprende relações entre imagens e outros sinais, como descrições associadas.
O volume, porém, não resolve tudo. Dados incompletos, desatualizados ou desbalanceados podem limitar o desempenho e reproduzir vieses. Além disso, o modelo pode não conhecer informações internas de uma empresa, como políticas, catálogo, procedimentos e histórico de atendimento.
Para fornecer conhecimento empresarial sem treinar o modelo novamente, uma aplicação pode buscar trechos relevantes em documentos autorizados e incluí-los como contexto da pergunta. Essa abordagem, chamada geração aumentada por recuperação, mantém a base consultável separada do modelo e permite atualizar documentos sem refazer todo o treinamento.
Na prática, uma empresa pode conectar um assistente a manuais de operação e pedir respostas baseadas nesses materiais. Ainda assim, precisa testar se a busca encontra as fontes certas e se o sistema evita responder quando não há evidência suficiente.
A arquitetura define como o conteúdo é produzido
Arquitetura é a estrutura computacional que processa os dados e gera a resposta. Para muitos modelos de linguagem atuais, uma arquitetura chamada Transformer permite relacionar diferentes partes da entrada durante o processamento. O trabalho de pesquisa que apresentou a arquitetura Transformer descreveu o mecanismo de atenção que se tornou central nessa abordagem.
Em um modelo de linguagem autorregressivo, a geração costuma ocorrer em sequência: o sistema prevê uma parte do texto e usa o que já produziu para calcular a próxima. Já modelos de difusão, comuns na geração de imagens, aprendem a remover ruído em etapas para formar uma imagem coerente. A pesquisa sobre modelos probabilísticos de difusão formaliza esse tipo de processo.
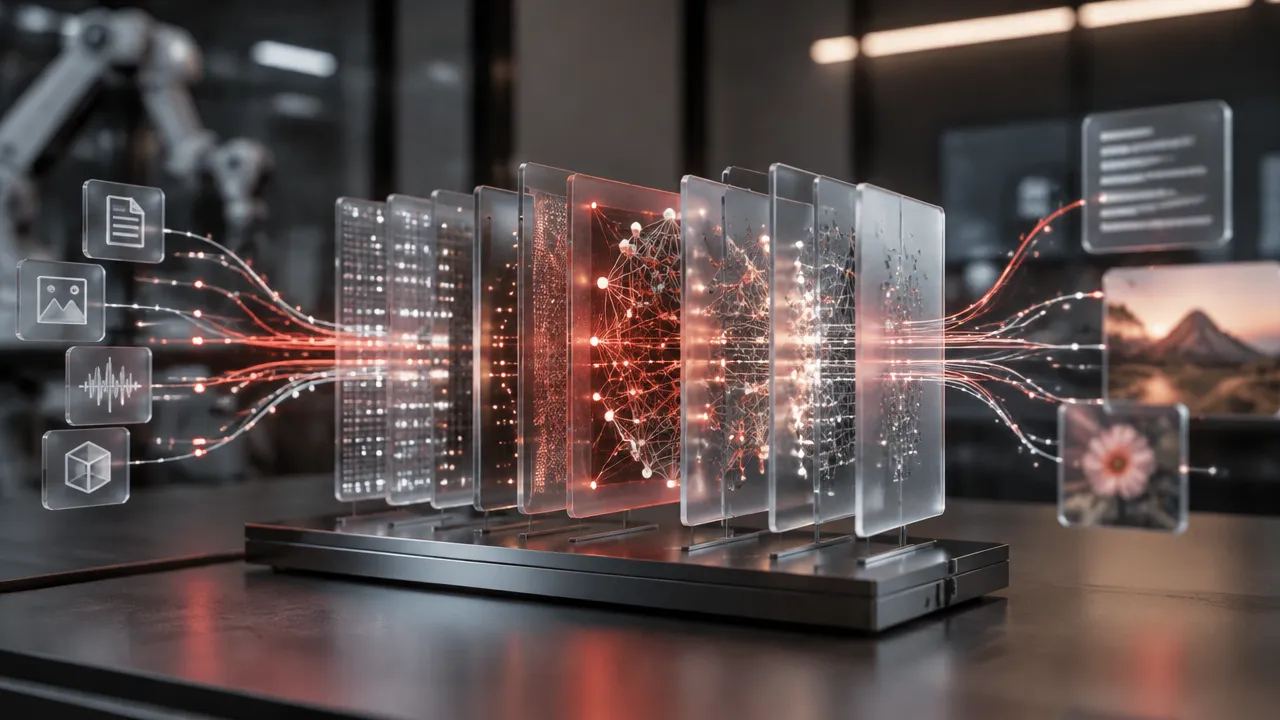
Há ainda modelos multimodais, capazes de trabalhar com mais de um formato, como texto e imagem. Isso abre possibilidades para analisar documentos digitalizados ou combinar instruções escritas com referências visuais. A capacidade exata varia conforme o modelo e a aplicação, então deve ser testada para a tarefa pretendida.
Texto, imagem e áudio pedem modelos diferentes
Os modelos se distinguem pelo tipo de dado, pela forma de geração e pelo problema que resolvem. A tabela resume famílias comuns, sem assumir que uma delas seja a melhor para todos os projetos.
| Família | Como gera | Exemplo de aplicação |
|---|---|---|
| Modelos de linguagem | Produzem texto ou código em sequência | Classificar solicitações, redigir respostas e apoiar programação |
| Modelos de difusão | Constroem uma saída ao refinar ruído progressivamente | Criar imagens conceituais a partir de instruções |
| Modelos de áudio | Reconhecem, transformam ou geram fala e som | Transcrever chamadas ou criar interfaces por voz |
| Modelos multimodais | Relacionam mais de um formato de entrada ou saída | Extrair informações de documentos com texto e imagens |
Essas categorias se sobrepõem: um sistema pode combinar capacidades ou ser integrado a outros componentes. Para aprofundar as diferenças entre famílias, a comparação de modelos de geração por difusão ilustra como a técnica de produção muda entre aplicações visuais e modelos de linguagem.
Instruções, busca e ajuste fino cumprem funções distintas
Adaptar um modelo não exige sempre treiná-lo novamente. A escolha mais simples costuma ser melhorar as instruções e fornecer exemplos. Isso funciona bem quando a tarefa é clara e o modelo já tem capacidade suficiente.
- Instruções: orientam formato, tom, limites e etapas da resposta.
- Busca em documentos: acrescenta contexto atualizado ou específico da empresa no momento da consulta.
- Ajuste fino: modifica o comportamento do modelo com exemplos de uma tarefa, quando as alternativas mais simples não bastam.
O treinamento com avaliações humanas é uma das técnicas estudadas para alinhar respostas a instruções. O artigo sobre treinamento com feedback humano descreve um processo de demonstrações, comparações entre respostas e otimização. Para um negócio, o ponto prático é definir o comportamento esperado e medir se a adaptação realmente melhora os resultados.
Escolha pelo trabalho que precisa ser resolvido
O melhor modelo não é necessariamente o mais amplo ou conhecido. É aquele que atende aos requisitos da tarefa dentro dos limites de custo, tempo, privacidade e qualidade. Antes de integrar uma API ou construir um produto, defina o que conta como uma resposta aceitável.
- Descreva a tarefa e os usuários, por exemplo, classificar pedidos recebidos ou resumir documentos internos.
- Monte exemplos reais, incluindo casos ambíguos, exceções e entradas incompletas.
- Compare modelos pela precisão, consistência, velocidade, custo por uso e formatos aceitos.
- Verifique como os dados são tratados e se a aplicação pode acessar apenas as informações autorizadas.
- Teste a solução dentro do fluxo de trabalho e mantenha revisão humana onde um erro tenha impacto relevante.
Na Vistapub, essa análise orienta projetos de aplicativos e automação com IA e ferramentas low-code. Em vez de começar pelo modelo da moda, o trabalho começa pelo processo: identificar entradas, saídas, integrações e pontos de validação. Assim, é possível decidir se basta conectar um modelo existente ou se o produto precisa de uma solução mais personalizada.
O resultado depende do sistema ao redor do modelo
Um modelo generativo é apenas uma parte da solução. Dados confiáveis, instruções bem definidas, acesso controlado a documentos, testes e acompanhamento determinam se a geração será útil no dia a dia.
Para explorar IA generativa em uma empresa, comece com uma tarefa delimitada e avalie resultados com exemplos reais antes de ampliar o uso. Essa abordagem reduz surpresas e ajuda a escolher uma arquitetura compatível com o problema, seja para criar conteúdo, apoiar equipes ou automatizar etapas de um processo.